爬取預算(Crawl Budget)是什麼?影響 SEO 抓取效率的 7 大關鍵
作者:SYBRAND 編輯團隊 · 2026/9/1
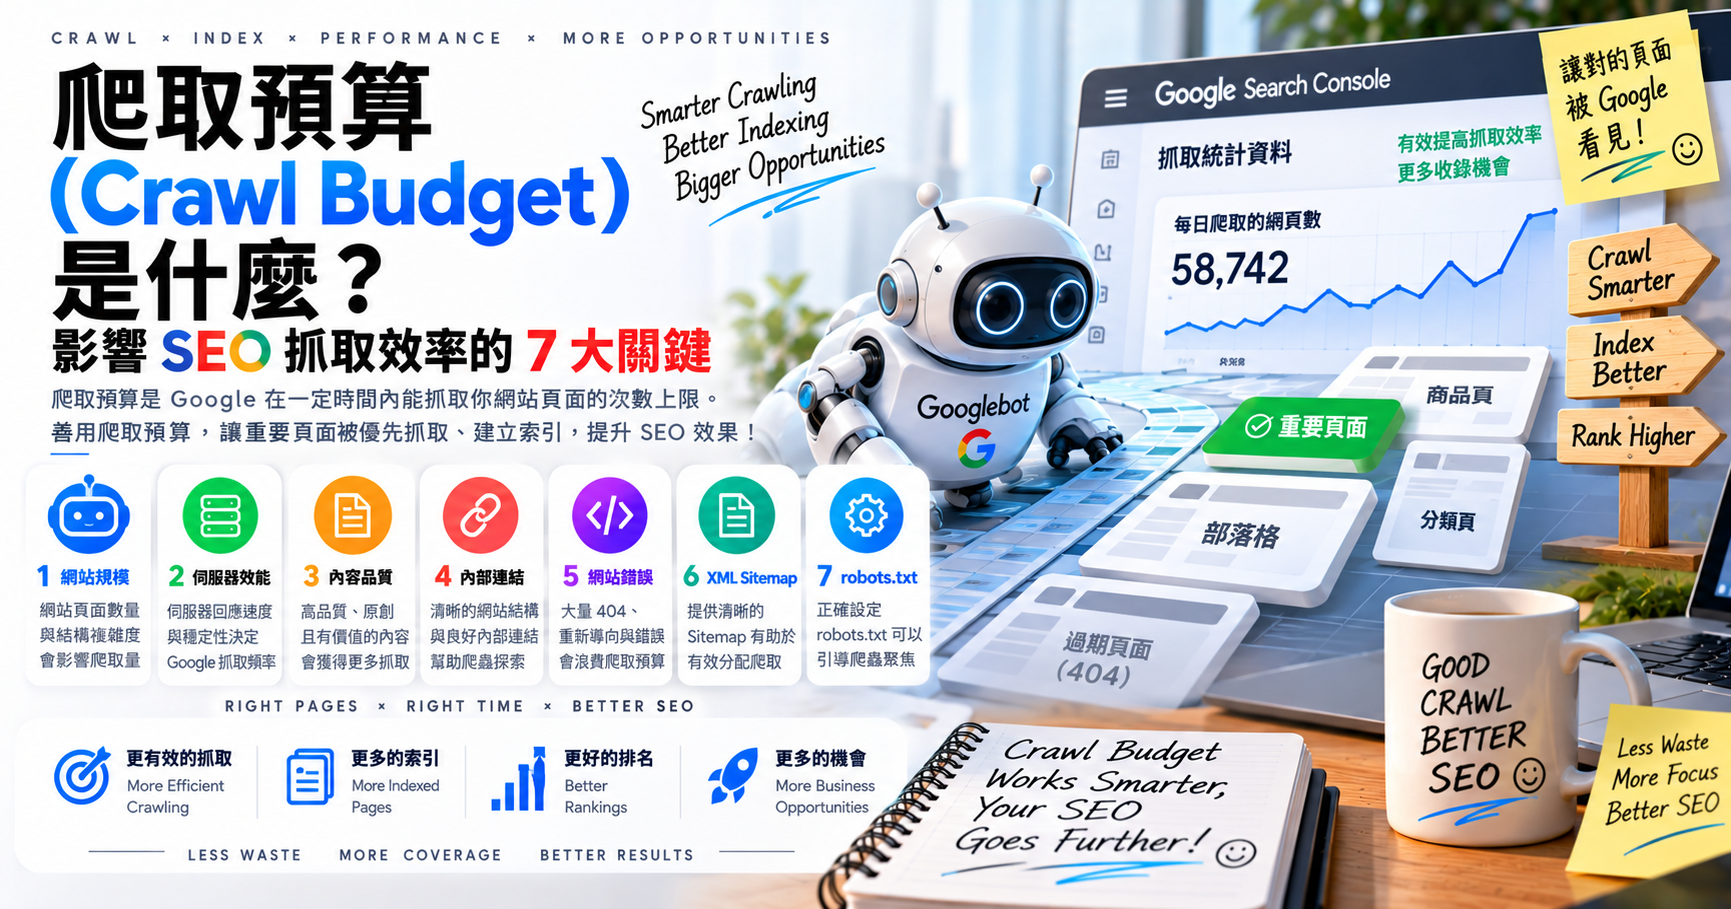
爬取預算是什麼:搜尋引擎分配給你網站的有限資源
爬取預算(Crawl Budget)指的是搜尋引擎願意在特定期間內,分配給某個網站的抓取次數與資源總量。這個概念的重要性會隨網站規模而異:對頁面數量有限的中小型網站而言,爬取預算通常不構成瓶頸,Google 多半能在短時間內抓取完所有重要頁面;但對於擁有數萬甚至數十萬頁面的大型網站、電商平台或內容聚合站台來說,若爬取資源被浪費在低價值頁面上,真正重要的新內容或更新內容,就可能被延遲發現與索引。
關鍵一、二:網站規模與伺服器回應速度
網站頁面總數是決定所需爬取預算量體的基本因素,頁面愈多,理論上需要的抓取次數也愈多。而伺服器的回應速度與穩定性則直接影響搜尋引擎爬蟲單次造訪能夠處理的頁面數量:當伺服器回應緩慢或頻繁出現錯誤,爬蟲為了避免對伺服器造成過大負擔,通常會主動放慢抓取速度,間接壓縮了整體的有效爬取量。
關鍵三、四:內部連結結構與重複內容
清晰且深度合理的內部連結結構,能協助爬蟲更有效率地發現與理解網站上的重要頁面;反之,若重要頁面被埋藏在過深的連結層級之下,可能長期未被充分爬取。另一方面,重複或高度相似的內容——例如同一商品因排序參數產生的多個網址版本——會讓爬蟲重複耗費資源在本質相同的頁面上,稀釋了原本可用於發現新內容的爬取預算。
關鍵五、六:URL 參數氾濫與 XML 網站地圖的準確度
篩選、排序與追蹤參數若未妥善管理,可能讓同一頁面內容衍生出大量網址變體,每一個變體都可能被爬蟲視為獨立頁面而個別抓取,造成預算的無謂消耗。與此同時,XML 網站地圖應僅涵蓋真正具備索引價值的正式網址,若地圖中夾雜大量已失效、重導向或不應被索引的頁面,等於是主動引導爬蟲把資源花在錯誤的地方。
關鍵七:爬取指令的衛生管理,讓 robots.txt 與 noindex 各司其職
robots.txt 應明確攔阻搜尋引擎爬取對排名毫無幫助的區塊,例如後台管理頁面或內部搜尋結果頁;而對於希望爬蟲能夠造訪、但不希望出現在搜尋結果中的頁面,則應使用 noindex 標籤而非直接於 robots.txt 中封鎖,因為完全被封鎖的頁面爬蟲根本無從得知其內容與狀態。正確區分這兩種機制的使用時機,是維持爬取指令乾淨且不自相矛盾的關鍵。
把爬取預算優化,視為長期的網站體質工程
爬取預算的優化沒有一次性的解方,而是需要透過網站健檢工具持續監測抓取統計、比對伺服器紀錄,找出資源被無謂消耗的環節,並隨著網站規模成長定期檢視前述七項因素的現況。對絕大多數網站而言,把力氣放在提升伺服器效能、清理重複內容與維持連結結構清晰,往往就能帶來最直接的改善效果。