AI Token 是什麼?一次搞懂 Token 計算、收費邏輯與省錢技巧!
作者:SYBRAND 編輯團隊 · 2026/9/1
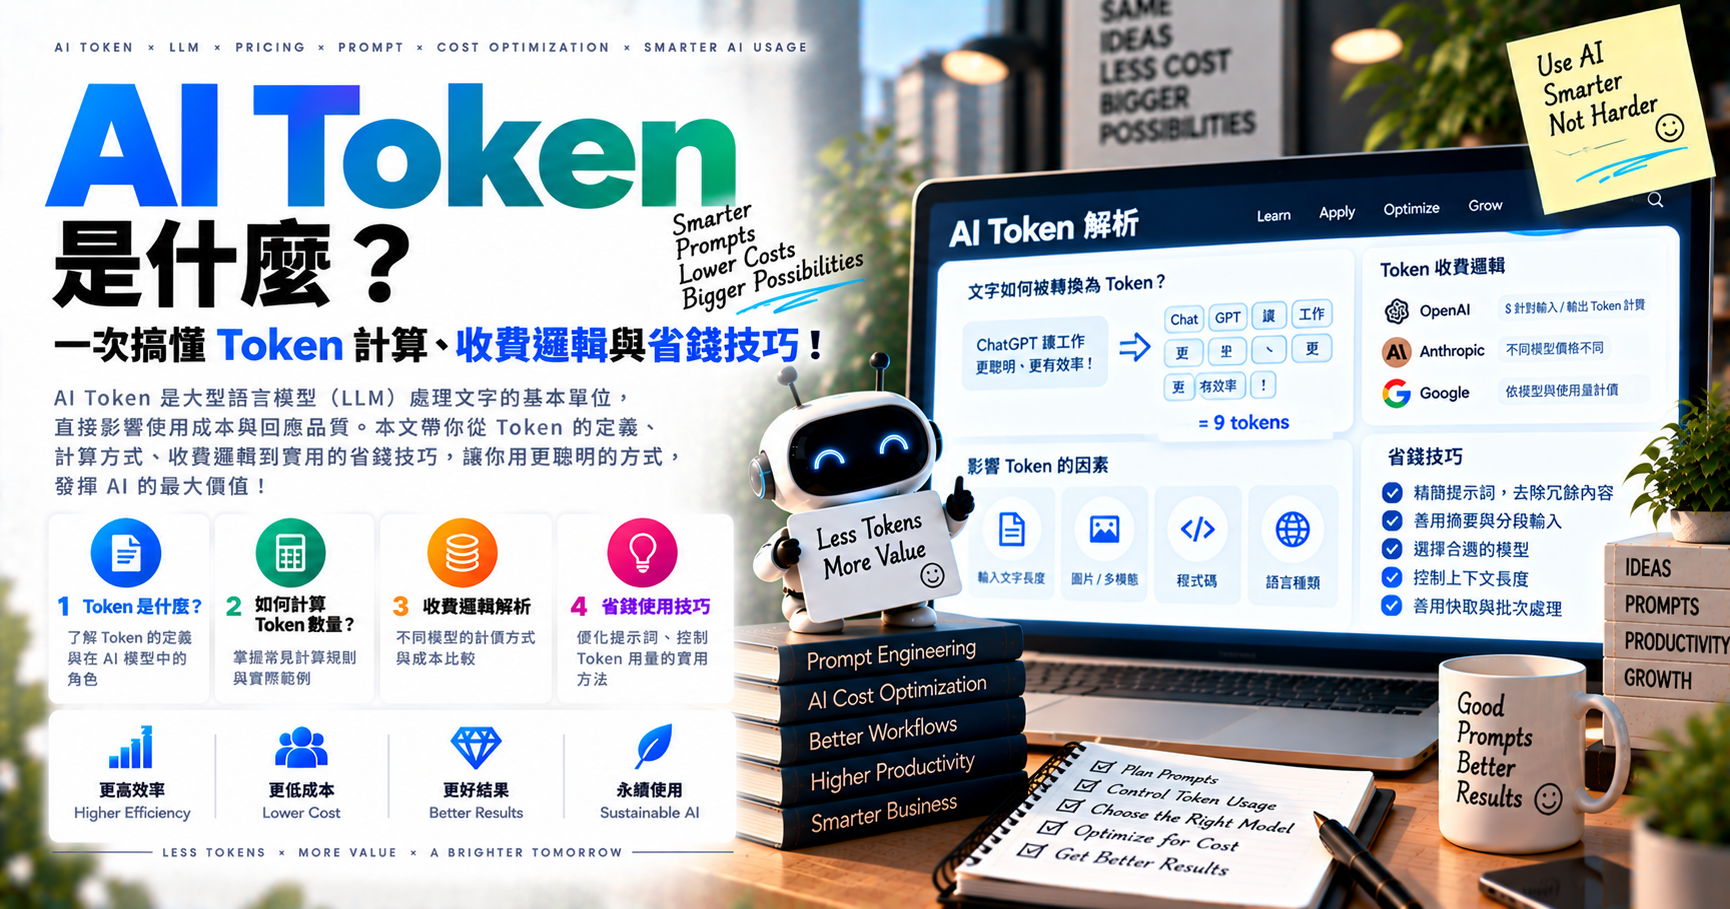
Token 是什麼:AI 模型處理文字的基本單位
Token 是大型語言模型在處理文字時所使用的基本單位,可以理解為模型將輸入與輸出的文字,切割成一個個更小的片段來進行運算與理解。這些片段不完全等同於一般認知中的「一個字」或「一個單字」,有時是一個完整的詞彙,有時則是詞彙的一部分,甚至可能是標點符號或空白字元,實際的切分方式取決於模型所採用的分詞(tokenization)方法。理解 Token 並非精確對應字數,是掌握後續計費邏輯的第一步。
為何多數 AI 服務以 Token 作為計費依據
AI 模型執行運算時所消耗的運算資源,與需要處理的 Token 數量直接相關——輸入的內容愈長、模型需要生成的回覆愈長,所需的運算量就愈大。因此,以 Token 數量作為計費基礎,能相對準確地反映每一次互動實際消耗的運算資源,這也是為何目前多數 AI API 服務普遍採用這種計費邏輯,而非單純以「使用次數」計費。多數服務會分別計算輸入 Token 與輸出 Token,兩者的計費方式與費率可能不同,實際費率會因服務商與模型而異且經常調整,這裡不引用特定數字,建議以各家官方公告為準。
常被忽略的成本來源:對話歷史與長文件
一個容易被忽略的重點是,在多輪對話情境中,為了讓模型維持上下文的理解,每一次新的提問通常需要連同先前的對話紀錄一併送出,這意味著對話愈長,每一次互動實際消耗的 Token 數量也會隨之累積增加,而不僅止於當下這一句提問的長度。同樣地,若在提問時附上長篇文件或大量參考資料作為背景資訊,即便使用者自己輸入的問題很簡短,實際計費仍會涵蓋這些背景資訊所佔用的 Token 數量。
省錢技巧:精簡提問內容與管理對話長度
在撰寫提示詞(prompt)時,盡量清楚且精簡地表達需求,避免不必要的重複敘述或冗長鋪陳;若需要提供背景資料,優先篩選出真正相關的重點內容,而非整份文件不加篩選地附上。同時,對於已經完成的任務或主題,適時結束當前對話並開啟新的對話串,能避免舊有的對話歷史持續累積,不必要地增加後續每次互動的 Token 消耗;若使用的工具支援,也可善用摘要方式,以精簡後的重點取代冗長的原始對話紀錄,作為後續對話的背景資訊。
省錢技巧:依任務複雜度選擇合適規模的模型
並非所有任務都需要動用效能最強、同時也通常收費最高的旗艦模型。對於格式判斷、簡單分類、基礎資訊擷取等相對單純的任務,選擇規模較小或收費較低的模型,往往已能滿足需求;只有在真正需要複雜推理、創意產出或高準確度判斷的任務上,才需要使用能力較強的模型。建立「依任務挑選對應規模模型」的使用習慣,長期而言是控制 AI 使用成本最根本且最有效的方式之一。