Googlebot 是什麼?網路爬蟲 & AI 爬蟲對 SEO / GEO 的影響
作者:SYBRAND 編輯團隊 · 2026/9/1
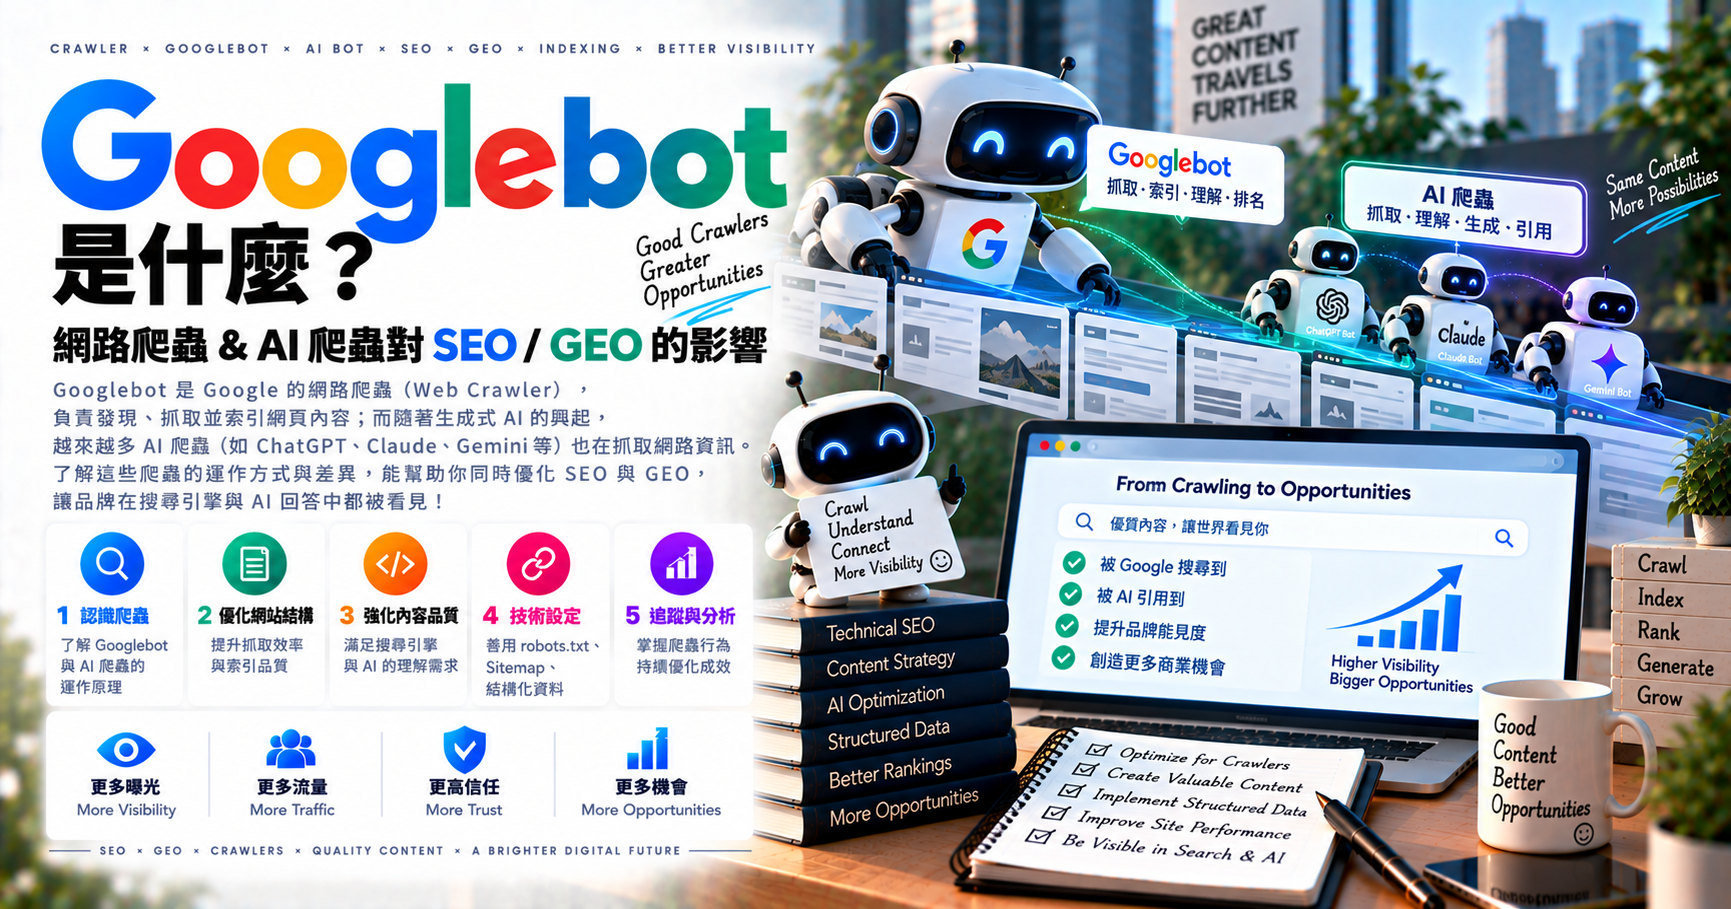
Googlebot 是什麼:搜尋引擎理解你網站的第一道關卡
Googlebot 是 Google 用來探索與蒐集網路上頁面內容的自動化程式,一般稱為網路爬蟲。它的基本工作流程包含三個階段:爬取(發現並下載頁面內容)、轉譯(執行頁面中的程式碼以呈現完整畫面,尤其是仰賴 JavaScript 動態產生內容的網站)與索引(將處理完成的內容納入 Google 的資料庫,作為日後回應使用者搜尋查詢時的候選來源)。品牌網站若無法被 Googlebot 順利完成這三個階段,即使內容再優質,也難以出現在自然搜尋結果之中。
robots.txt 與 meta robots:指揮爬蟲行為的兩層規則
網站可透過放置於根目錄的 robots.txt 檔案,概略指示 Googlebot 哪些路徑可以或不建議爬取;而在個別頁面層級,則可透過 meta robots 標籤,更精細地控制該頁面是否應被索引,或是否應該追蹤頁面上的連結。這兩層規則搭配運用,讓網站經營者得以在爬蟲資源有限的前提下,引導 Googlebot 優先關注真正重要的內容,避免時間被大量重複或低價值頁面稀釋。
AI 爬蟲登場:一群性質不同的新訪客
除了 Googlebot 這類服務傳統搜尋引擎的爬蟲,近年市場上也出現了一批與生成式 AI 搜尋、對話式答案引擎相關的爬蟲程式,它們造訪網站的目的,往往是為了蒐集內容以供訓練模型或即時生成答案時參考引用,而非單純建立傳統的關鍵字索引。這類 AI 爬蟲的行為模式、造訪頻率與各家廠商所遵循的規範,與經營多年、規則相對成熟的 Googlebot 相比,仍處於相對早期且持續變動的階段。
SEO 與 GEO 需要並行思考的存取規則
這意味著網站經營者現在必須同時思考兩套權限與呈現邏輯:一套是為了傳統 SEO,透過 robots.txt 與 meta robots 管理 Googlebot 的爬取與索引行為;另一套則是為了 GEO,思考是否、以及如何讓與生成式 AI 相關的爬蟲順利存取並理解網站上值得被引用的內容,這也正是本專欄前一篇文章介紹的 llms.txt 這類新興嘗試所要回應的課題——用一份對機器友善的精簡清單,輔助 AI 爬蟲更有效率地找到網站真正的重點內容。
實務建議:定期檢視雙軌爬蟲的存取狀況
建議品牌定期檢視伺服器日誌,觀察 Googlebot 與各類 AI 爬蟲實際的造訪頻率與涵蓋範圍,並對照 robots.txt 與相關規則設定是否仍然合乎目前的策略意圖。由於 AI 爬蟲的規範與各家政策仍在持續演進,這項檢視不會是一次性的設定工作,而應納入網站長期維運中,與傳統 SEO 技術健檢並列的例行項目之一。